Overslaan naar de hoofd content

Mephana

Datum

12 november 2026

Leestijd

7 minuten lezen

Kleine taalmodellen in de praktijk met Murmur

Auteur

Ian van Eenennaam

Inleiding

Wat wordt praktisch mogelijk als een compact AI-model zowel taal als spraak kan verwerken op een gewone computer? De mogelijkheden raken aan alledaags werk: een onduidelijke taak bespreken, een idee omzetten in een bericht of een vervolgvraag stellen zonder weer naar het toetsenbord te grijpen.

Ik bouwde Murmur om die vraag te onderzoeken. De toepassing brengt lokale modellen samen in een gespreksomgeving waarin je kunt typen, een bericht kunt opnemen of een gesprek zonder handen kunt starten. Het project maakt het mogelijk te onderzoeken hoe steeds capabelere kleine taalmodellen passen bij vertrouwde activiteiten, en wat nog aandacht vraagt voordat daar betrouwbare toepassingen uit ontstaan.

Belangrijkste inzichten

01

Compacte modellen krijgen steeds meer mogelijkheden.

Taal en spraak kunnen samenkomen in een model dat klein genoeg is voor een gewone computer.

02

Gerichte gesprekken wijzen op nuttige toepassingen.

Plannen, schrijven, oefenen en leren bieden concrete situaties om te onderzoeken.

03

Praktische bruikbaarheid moet je toetsen.

De kwaliteit van antwoorden, hardware, wachttijd en het ontwerp van de interactie bepalen samen of een toepassing helpt.

Wat kleine modellen mogelijk maken

Kleine taalmodellen, of SLM’s, brengen de benodigde rekenkracht voor taalverwerking binnen het bereik van meer apparaten. Hun groeiende mogelijkheden veranderen ook welke toepassingen het onderzoeken waard zijn. Een model dat spraak begrijpt en tekst genereert, kan deelnemen aan een gesproken gesprek en tegelijk een leesbaar verslag bijhouden.

LFM3-Omni-2B van Liquid AI illustreert deze ontwikkeling. Volgens de maker heeft het model ongeveer 2,2 miljard parameters en ondersteunt het tekst, afbeeldingen, video en audio als invoer, met tekst en spraak als uitvoer. Dat zijn mogelijkheden van het model; om ze bruikbaar te maken in een toepassing is ook de omliggende software nodig. Modeldocumentatie van Liquid AI

Voor deze verkenning richtte ik me op gesprekken en transcriptie. Die afbakening maakt de vraag concreet: kan een compact model een nuttig gesprek ondersteunen op de computer waarop iemand al werkt? Ook tekortkomingen worden zo beter zichtbaar, van een verkeerd begrepen zin tot een antwoord dat de gevraagde vorm negeert.

Een werkende verkenning met Murmur

Murmur gebruikt Ollama om geïnstalleerde modellen uit te voeren. Het geselecteerde LFM3 Omni-model verzorgt zowel transcriptie als het gesprek, terwijl Phonon het antwoord omzet in spraak. Tekst verschijnt tijdens het genereren en gesproken antwoorden kunnen beginnen zodra zinsdelen beschikbaar zijn. Je kunt het antwoord lezen, beluisteren of opnieuw afspelen.

De toepassing ondersteunt handmatig opnemen en een sessie zonder handen die je zelf expliciet start. Lokale detectoren herkennen spraak en helpen bepalen wanneer een spreekbeurt klaar is. De huidige spraakverkenning richt zich op Engels en houdt de transcriptiestap zichtbaar.

Dezelfde SAPUI5-interface werkt in een browser en in een lokaal verpakte Electron-app voor Macs met Apple silicon. De desktopversie bevat de benodigde app-runtime en beheert de backend; Ollama en de modellen voor inferentie installeer je apart. Zo wordt het experiment toegankelijk als toepassing en blijft duidelijk welk model je gebruikt.

Vier situaties om te onderzoeken

De ingebouwde gespreksbediening vormt een basis voor vier toepassingen die het waard zijn om met representatieve taken te toetsen.

Een taak doordenken

Stel dat je een workshop voorbereidt. Het doel is duidelijk, maar de volgorde van het werk nog niet. Je kunt de deelnemers, beschikbare tijd en gewenste uitkomst beschrijven en om een kort voorbereidingsplan vragen. In een vervolgvraag kun je een randvoorwaarde toevoegen: de deelnemers hebben verschillende ervaringsniveaus, of de voorbereiding moet in één middag passen.

Het model heeft de relevante randvoorwaarden nodig om bruikbare voorstellen te doen. Die voorwaarden verwoorden en aanscherpen is juist een deel van de waarde: het gesprek helpt je duidelijk te maken wat belangrijk is en mogelijke vervolgstappen te onderzoeken voordat je een plan vastlegt.
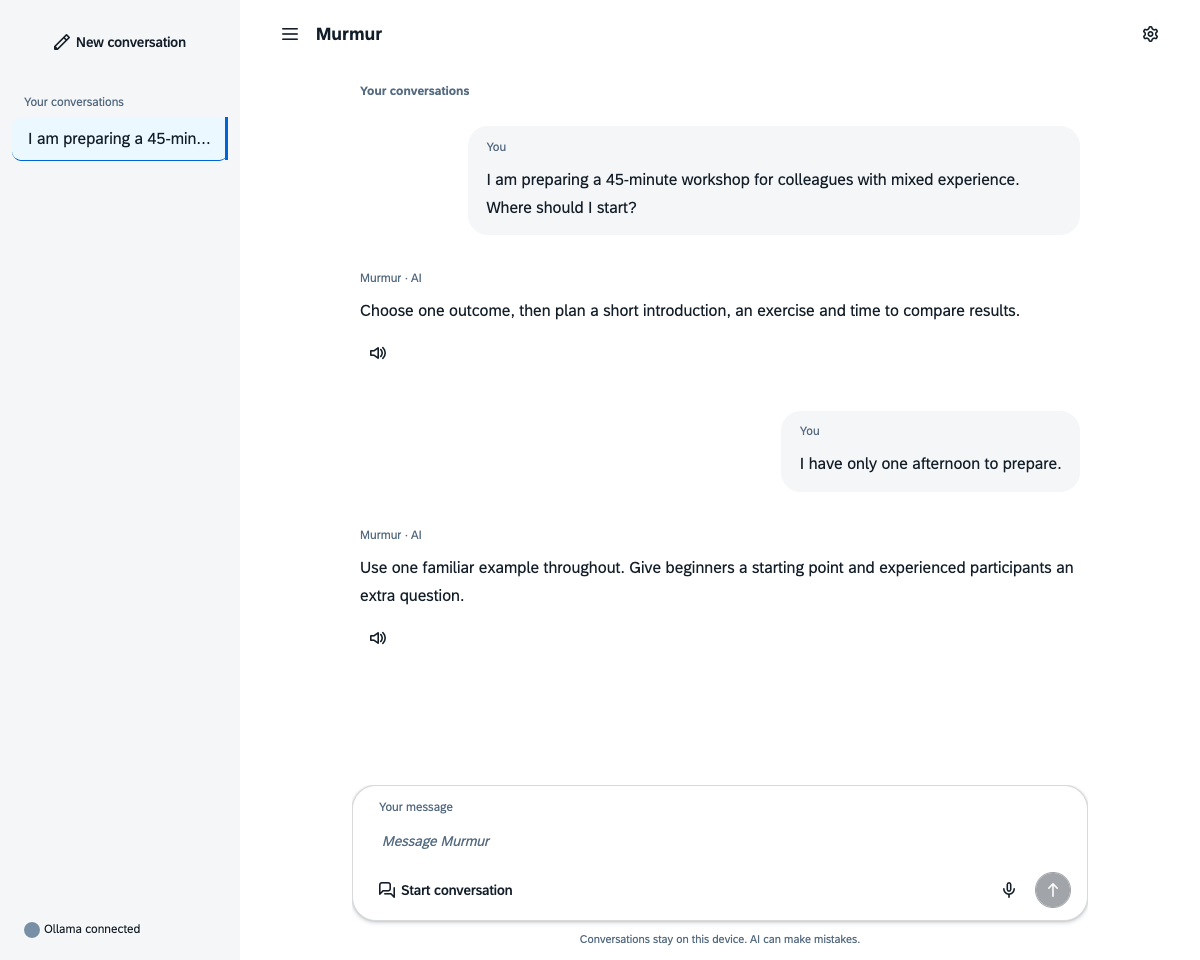
Een gesprek in Murmur helpt een workshop opzetten met een duidelijk resultaat, een oefening en tijd om uitkomsten te vergelijken.
Een taak doordenken in de volledige interface van Murmur, met vooraf geschreven voorbeelddialoog.

Een gesproken concept uitwerken

Een eerste versie van een bericht begint vaak als een paar losse gedachten. Je kunt kort inspreken waarom een project vertraging heeft en vervolgens om een bondige update vragen over de oorzaak, de gevolgen en de volgende stap. In de zichtbare transcriptie kun je een verkeerd begrepen naam of datum herkennen en in een vervolgbericht corrigeren.

Dit biedt een bruikbare brug tussen spreken en schrijven. Het concept blijft in het gesprek staan, zodat je het op juistheid en toon kunt controleren, aanscherpen en hergebruiken.
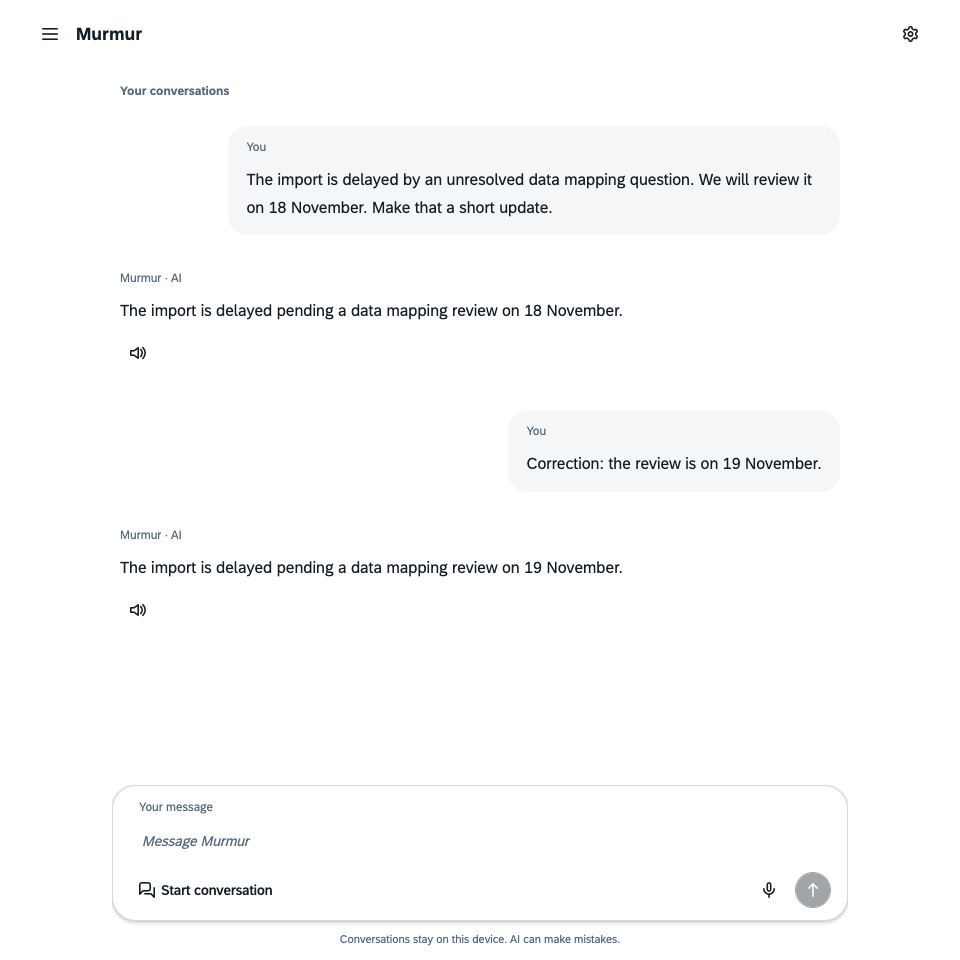
Murmur toont een conceptbericht over projectvertraging en een vervolgbericht dat de beoordelingsdatum corrigeert naar 19 november.
Een scenario voor een gesproken concept, met gesimuleerde opname, aangeleverde transcriptie en vooraf geschreven antwoorden.

Een uitleg oefenen

Een ontwikkelaar die een technisch voorstel gaat toelichten, kan een korte inleiding oefenen, vragen welke begrippen uitleg nodig hebben en om een eenvoudigere versie voor een collega vragen. Een alternatief hardop horen kan helpen beoordelen of het natuurlijk klinkt voor het beoogde publiek.

De relevante mogelijkheid is de combinatie van transcriptie, vervolgvragen en gesproken uitvoer. Dit scenario gaat over de inhoud en formulering van een uitleg; voor beoordeling van uitspraak of presentatie zijn aanvullende functies en tests nodig. Het praktische doel is een uitleg vinden die de spreker met vertrouwen kan gebruiken.
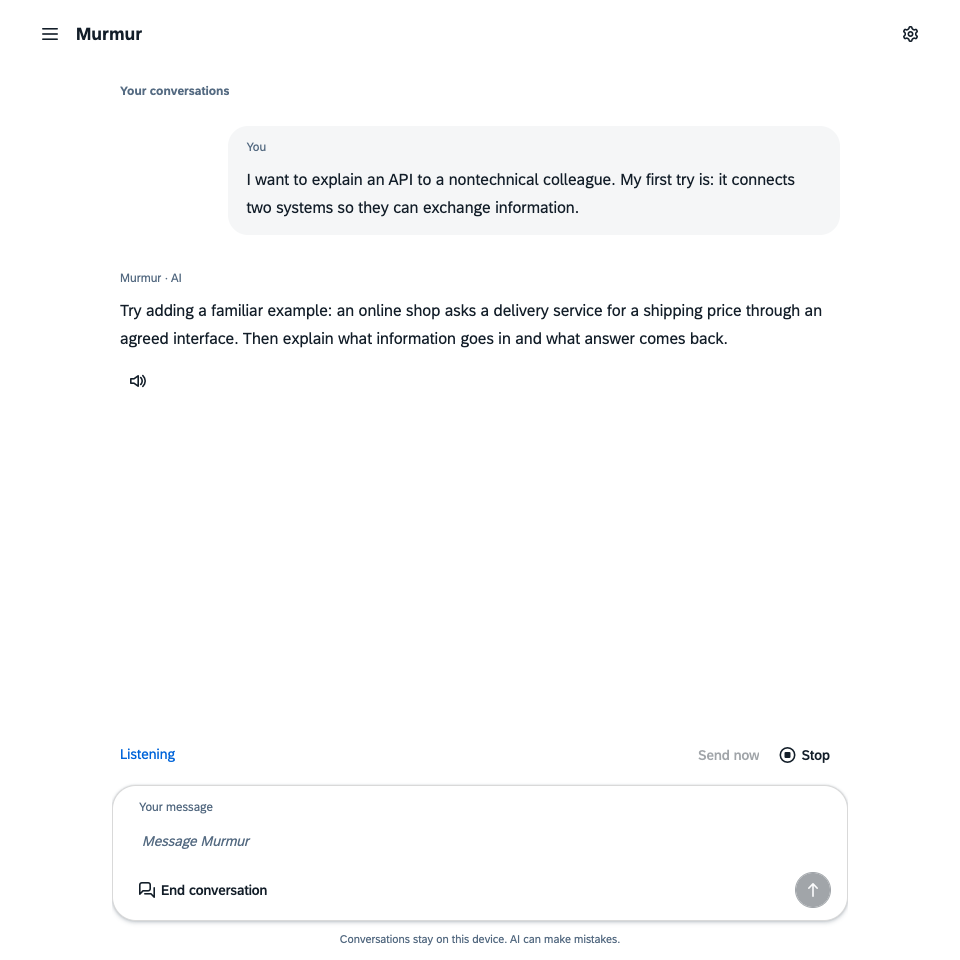
Murmur toont een voorbeeld van een API-uitleg, met de knoppen Listening, Stop en End conversation in beeld.
Een scenario om een uitleg te oefenen, met vooraf geschreven dialoog en gesimuleerde spraakinvoer. Stop en End conversation blijven zichtbaar.

Een begrip verkennen

Als je over een onbekend onderwerp leest, kun je om uitleg vragen, een concreet voorbeeld opvragen en vervolgens onderzoeken wat er verandert bij een andere aanname. In een gesproken gesprek kun je een antwoord onderbreken om eerst een begrip te verduidelijken.

Dat maakt leren via gesprekken een veelbelovend terrein, vooral voor korte vragen die op elkaar voortbouwen. Feitelijke betrouwbaarheid blijft daarbij essentieel. Murmur heeft geen ingebouwd proces voor webonderzoek of broncontrole, dus belangrijke uitleg moet je toetsen aan betrouwbare informatie.
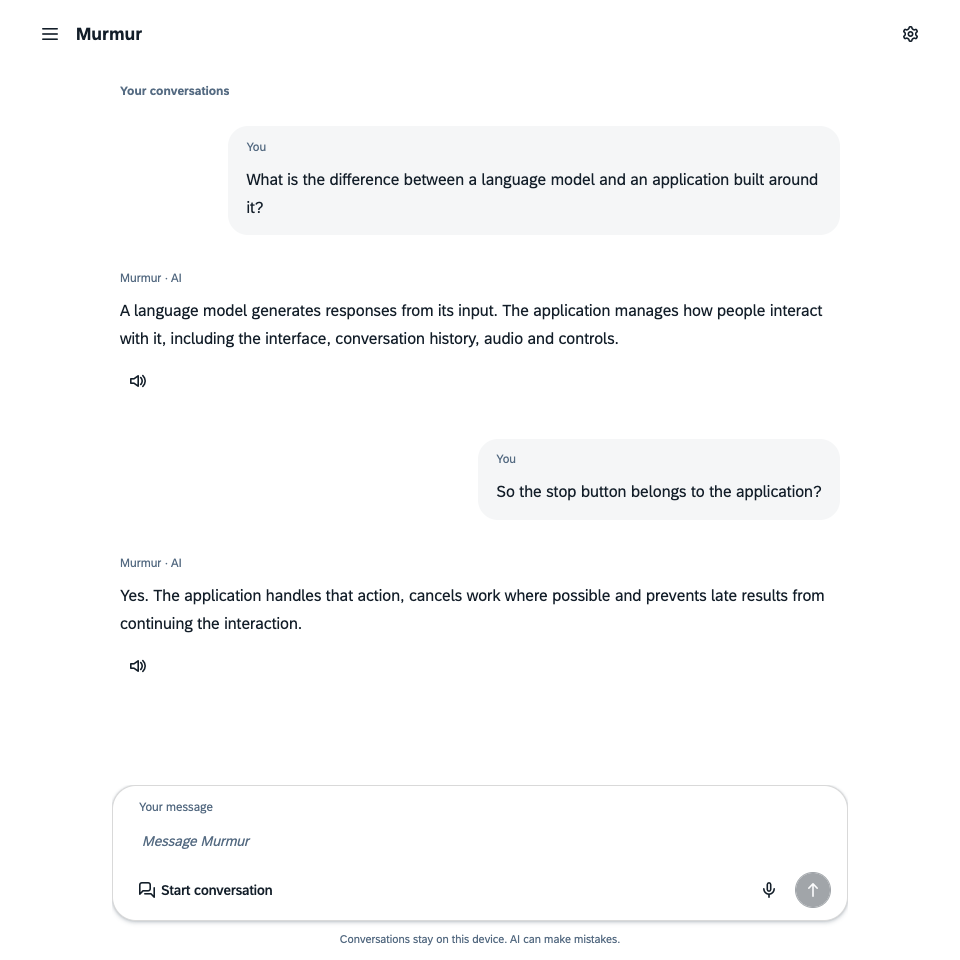
Een gesprek van twee beurten in Murmur over het verschil tussen een taalmodel en appbediening zoals Stop.
Een begrip verkennen met vervolgvragen. Dit is vooraf geschreven voorbeelddialoog, weergegeven in de echte interface van Murmur.

Wat de experimenten lieten zien

Lokale experimenten op 2 november 2026 draaiden op een Apple M3 met acht cores, 16 GiB geheugen en Ollama 0.40.13. De metingen hebben betrekking op die combinatie van hardware en software.

Een praktische bevinding ging over kwantisatie: modelgewichten weergeven met minder numerieke precisie. Na enkele opwarmende gesprekken rapporteerde Ollama ongeveer 3,09 GB toegewezen modelgeheugen voor de MXFP8-variant en 2,41 GB voor NVFP4, circa 22% minder. Deze cijfers betreffen alleen de gerapporteerde geheugentoewijzing voor het model; ook de toepassing, het besturingssysteem en het afzonderlijke spraakmodel gebruiken geheugen.

De variant met lager geheugengebruik bleek niet consequent sneller. Een schijnbare verbetering in de eerste vergelijking was bij een vervolgrun niet te herhalen. Beide varianten slaagden voor een kleine reeks inhoudelijke antwoordcontroles, maar voegden soms woorden toe terwijl alleen een naam of getal was gevraagd. Dat is een bemoedigend aanknopingspunt voor verder onderzoek, met een duidelijke reden om iedere beoogde taak afzonderlijk te testen.

Hetzelfde model gebruiken voor transcriptie en gesprekken voorkwam ook de modelwissels uit een eerder experiment. Het model in het geheugen houden verminderde in die runs de overhead van laden. Koude starts en de overige verwerkingsstappen bleven wel van invloed.

De antwoordvertraging varieerde nog genoeg om de gespreksstroom te beïnvloeden. In een afzonderlijke controle van de verwerkingsketen duurden drie spreekbeurten ongeveer negentien, acht en vijf seconden vanaf het einde van de gedetecteerde spraak tot het begin van afspelen. De controle gebruikte synthetische audio op een drukbezette computer, met gedempt geluid; het gedrag van een fysieke microfoon en de hoorbare kwaliteit moeten nog op echte apparaten worden getest. Voor de voorgestelde toepassingen is de wachttijd die een taak toelaat daarom een belangrijk ontwerppunt.

Het gesprek bruikbaar maken

Een uitgesproken gedachte kan na een pauze verdergaan. Ook kan iemand halverwege een antwoord van richting veranderen. Murmur maakt onderscheid tussen doorgaan met spreken voordat een antwoord hoorbaar wordt en een antwoord onderbreken dat al wordt afgespeeld. Bij een onderbroken gesproken antwoord komen alleen volledig afgespeelde fragmenten in de latere modelcontext terecht. Zo blijft het gesprek dichter bij wat iemand daadwerkelijk heeft gehoord.

Leesbare tekst, Replay en direct stoppen geven je manieren om de interactie te controleren en te sturen. Gesprekken zijn standaard tijdelijk. Tekst en voorkeuren onthouden is optioneel; audio en niet-verzonden concepten worden niet opgeslagen.

De verwerking gebeurt standaard op dezelfde computer. Na de eerste downloads zijn de benodigde appbestanden lokaal beschikbaar. Je kunt expliciet kiezen voor een Ollama-server op een privénetwerk of VPN. Gespreksgegevens en opnamen voor transcriptie worden dan naar die server gestuurd. Door dit onderscheid zichtbaar te houden, kun je een inrichting kiezen die bij je werk past.

Een nuttige rol kiezen voor kleine modellen

Murmur laat een praktische richting zien: compacte modellen kunnen meerdere mogelijkheden bieden die nodig zijn voor gerichte gesprekstoepassingen op een gewone computer. De situaties hierboven zijn behapbare uitgangspunten om te beoordelen of die mogelijkheden helpen bij echt werk.

De volgende stap is testen met representatieve taken, inclusief correcties, onduidelijke verzoeken en antwoorden die niet voldoen. Sommige werkprocessen passen bij een klein lokaal model; andere hebben krachtigere modellen, betrouwbare informatiebronnen of aanvullende bediening nodig.

Voor mij ligt de kans in het koppelen van steeds capabelere SLM’s aan activiteiten waarin hun specifieke sterke punten nuttig zijn. Overweeg je een werkproces waarbij lokale gesprekken, spraak of gerichte AI-ondersteuning kunnen helpen, dan bespreek ik graag wat het onderzoeken waard is.

Laten we kennismaken

Heb je een project in gedachten?

Vertel wat de uitdaging is en welk resultaat je zou helpen.

Nieuwsbrief

Ontvang de volgende editie

Praktische ideeën en technische experimenten van Ian van Eenennaam.

Aanmelden voor de nieuwsbrief